V100 vs 5080 多平台大模型部屬實測報告
硬件推理能力測試
AI 模型越來越大,但硬體要怎麼選?
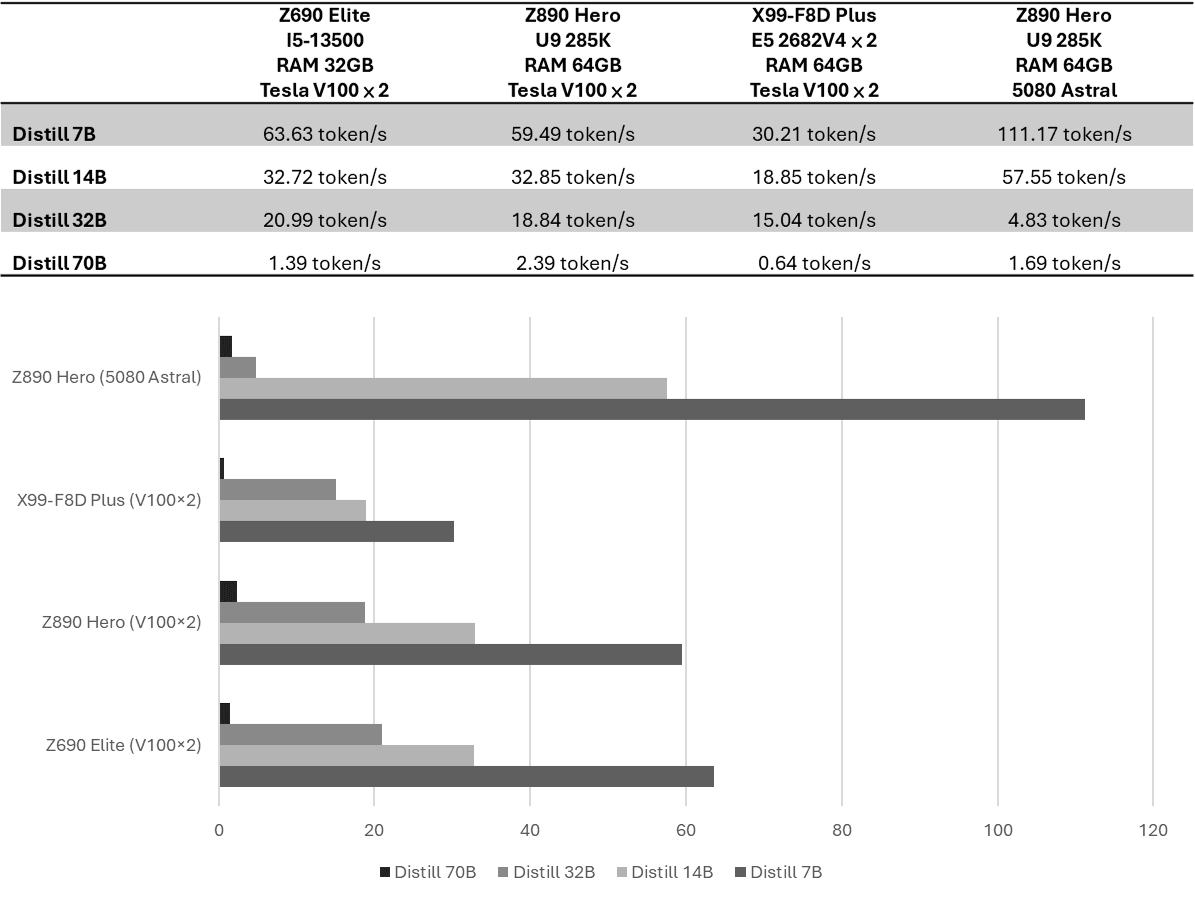
這次我們實測了多套平台,包含 Z690 / Z890 / X99 ,測試模型為 Distill 7B、14B、32B、70B,結果相當有趣
📌一、測試重點
V100 雙卡平台(16GB×2)
售價:NT$26,900(自組套裝)
穩定支撐 7B~70B 模型
功耗落在 20~50% TDP,顯示仍有運算餘裕
RTX 5080 Astral 單卡(16GB)
售價:NT$55,990
小模型(7B、14B)生成速度超快
但在 32B 以上模型效能明顯下滑
📋二、實測結果
CPU 差異對 LLM 推理幾乎沒有明顯影響(誤差約 5~10%)
V100 雙卡在大型模型更穩定,效能下滑幅度小
5080 在小模型領先,但受限於 VRAM 與頻寬,在 32B 以上掉速嚴重
推理過程中,V100 與 5080 的功耗都只有 TDP 的 20℅~50℅ 左右
🔌三、為什麼功耗吃不滿?
這是 LLM 推理的共通特性:
推理是逐 token 生成,GPU 有大量 idle gap
記憶體頻寬成為主要瓶頸
單請求 batch 過小,核心無法完全填滿
驅動會自動降頻壓功耗(DVFS 機制)
換句話說,GPU 沒有滿載不是壞事,而是代表還有潛力可以被利用。
📈四、V100 的潛力:多用戶併發伺服器
這次的實測也發現:
雙卡 V100 在推理時只用了 30~50% 功耗,代表它在單用戶任務時還有大量算力餘裕。
如果在部署時使用 vLLM / TensorRT-LLM / TGI 之類的框架,將批次(batch)或同時請求數(concurrent requests)調高,V100 雙卡能輕鬆支撐 8~32 位使用者同時推理,功耗同步上升、吞吐量可提升 2~4 倍。
結論:V100 雙卡非常適合多用戶訪問或 API 部署場景,在相同預算下可提供更高的整體算力與穩定性。
💰五、性價比結論
RTX 5080:速度快、適合單人推理
Tesla V100×2:穩定、大模型友善、可多用戶同時運行
價格對比:V100 雙卡 NT$26,900 ≒ 5080 的一半價錢
但可獲得 60~80% 效能 + 雙卡並行能力
最終觀察
CPU 對 LLM 推理影響極小;真正的關鍵在 GPU 架構與記憶體頻寬。
5080 適合個人實驗,而 V100 雙卡平台則是中小企業與研究單位最實際、最划算的選擇。